무료 OCR 뭐 쓸까 — 한글 OCR 도구·AI 모델 정리
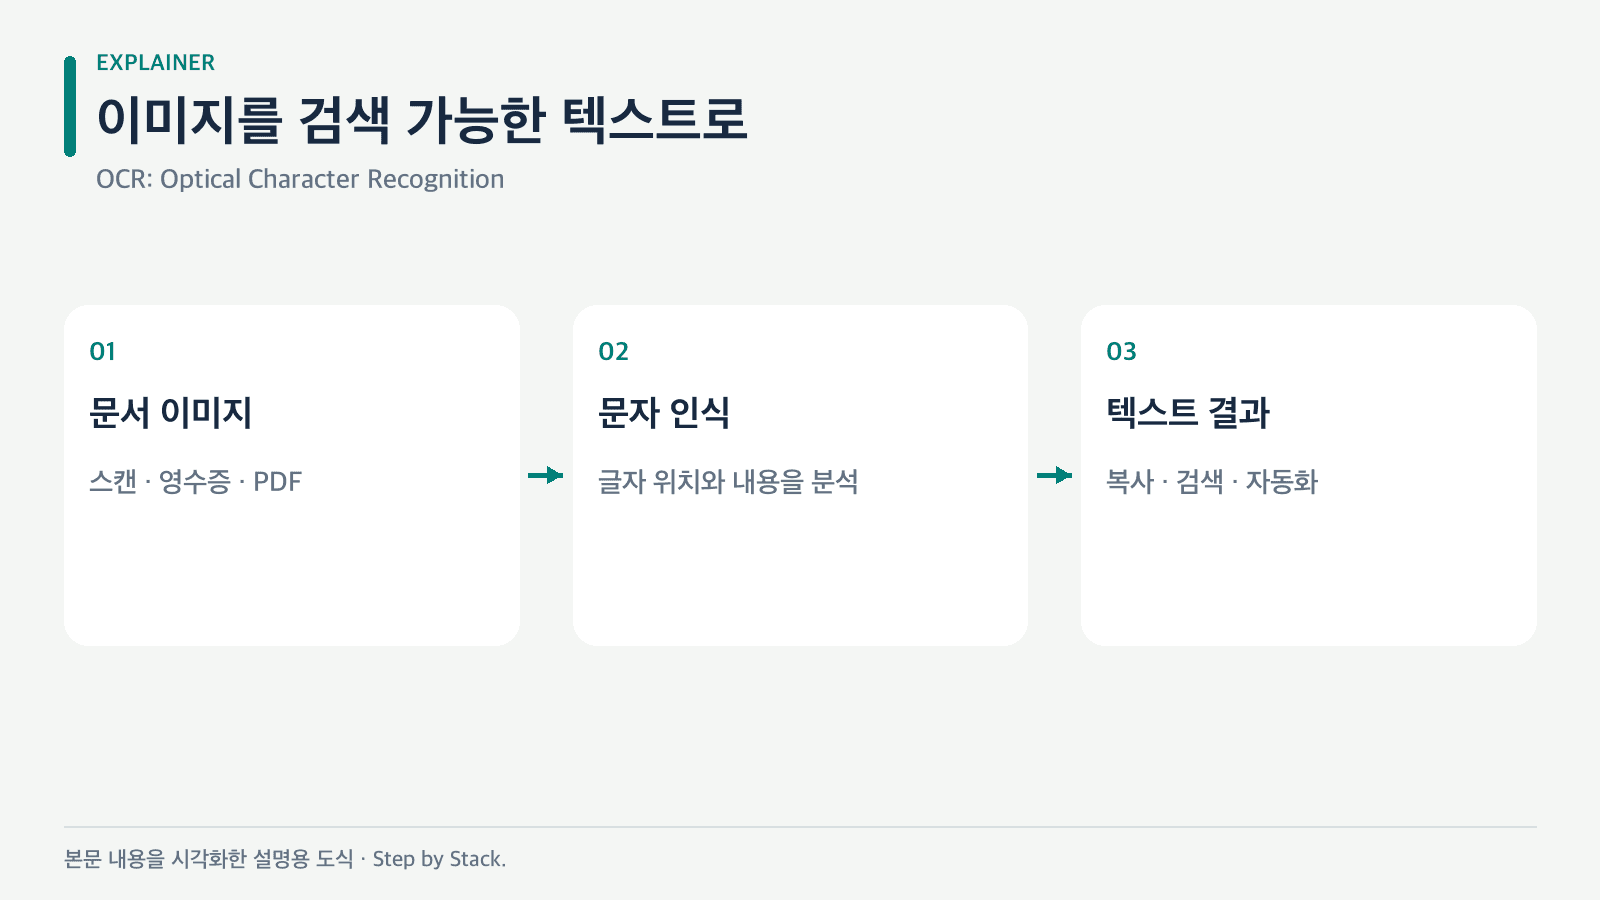
2026년 들어 OCR(광학 문자 인식) 판이 눈에 띄게 흔들렸다. 영수증·PDF·캡처 화면에서 글자를 뽑아내는 이 작업은 오랫동안 Tesseract 같은 전통 엔진의 몫이었는데, 2025년 10월 DeepSeek-OCR이 공개되고 PaddleOCR-VL이 문서 벤치마크 1위에 오르면서 "작지만 똑똑한 AI OCR"이 무료로 쏟아지고 있다. 이 글은 공짜로 쓸 수 있는 OCR을 전통형과 AI형으로 나눠 정리하고, 한글 문서·대량 처리·민감 자료 같은 상황별로 무엇을 고르면 되는지 판단 기준과 로컬 실행 방법까지 한 번에 짚는다.
핵심 요약
- 한두 장 가볍게 처리할 거면 전통 엔진 Tesseract(한글
kor지원, 100개 이상 언어)로 충분하다. - 표·레이아웃·수식까지 구조를 살려야 하면 2026년 새 물결인 문서 특화 AI OCR이 답이다.
- 오픈 벤치마크 OmniDocBench v1.6 기준 PaddleOCR-VL(96.3%) 이 1위, MinerU2.5-Pro(95.75%)·GLM-OCR(95.22%)가 그 뒤를 잇는다.
- PaddleOCR-VL은 0.9B 크기라 FP16에서 VRAM 약 2GB 면 돌아가, 일반 PC나 홈서버에서도 로컬 실행이 현실적이다.
- 민감 문서는 업로드형 무료 웹서비스 대신 로컬 오픈소스로 처리해 유출 위험을 줄이는 편이 안전하다.
OCR, 2026년에 뭐가 달라졌나
예전의 OCR은 "글자 영역을 찾아 한 글자씩 인식"하는 방식이었다. Tesseract는 버전 5부터 LSTM 신경망 엔진을 쓰고, 100개 이상 언어·35종 이상 문자를 공식 지원한다. 인쇄체가 또렷한 문서라면 이 방식만으로도 여전히 쓸 만하다.
2025년 하반기부터 흐름이 바뀌었다. 문서를 통째로 이해하는 비전·언어 모델(VLM) 기반 OCR이 쏟아진 것이다. 상징적인 사건이 2025년 10월 20일 공개된 DeepSeek-OCR이다. 이 모델은 "Contexts Optical Compression"이라는 이름 그대로 텍스트를 이미지로 압축해 처리하는 접근을 내세웠고, MIT 라이선스로 풀려 공개 몇 달 만에 깃허브 별 2만 4천 개를 넘겼다. 공식 소개에 따르면 A100-40G 한 장에서 초당 약 2,500토큰을 처리하고, 공개 사흘 만에 vLLM 지원까지 붙었다.
비슷한 시기에 등장한 문서 특화 모델들이 전통 엔진을 벤치마크에서 앞질렀다. 공개 문서 OCR 벤치마크인 OmniDocBench v1.6에서 PaddleOCR-VL이 96.3%로 최고 성적을 냈고, 이어 MinerU2.5-Pro(95.75%), GLM-OCR(95.22%) 순이다. 핵심은 이 모델들이 수백억 파라미터짜리 거대 모델이 아니라 1B 안팎의 작은 모델이라는 점이다. 작아서 공짜로 받아 집에서 돌릴 수 있고, 그만큼 "무료 OCR"의 선택지가 넓어졌다.
무료 OCR 지도 — 전통형과 AI형
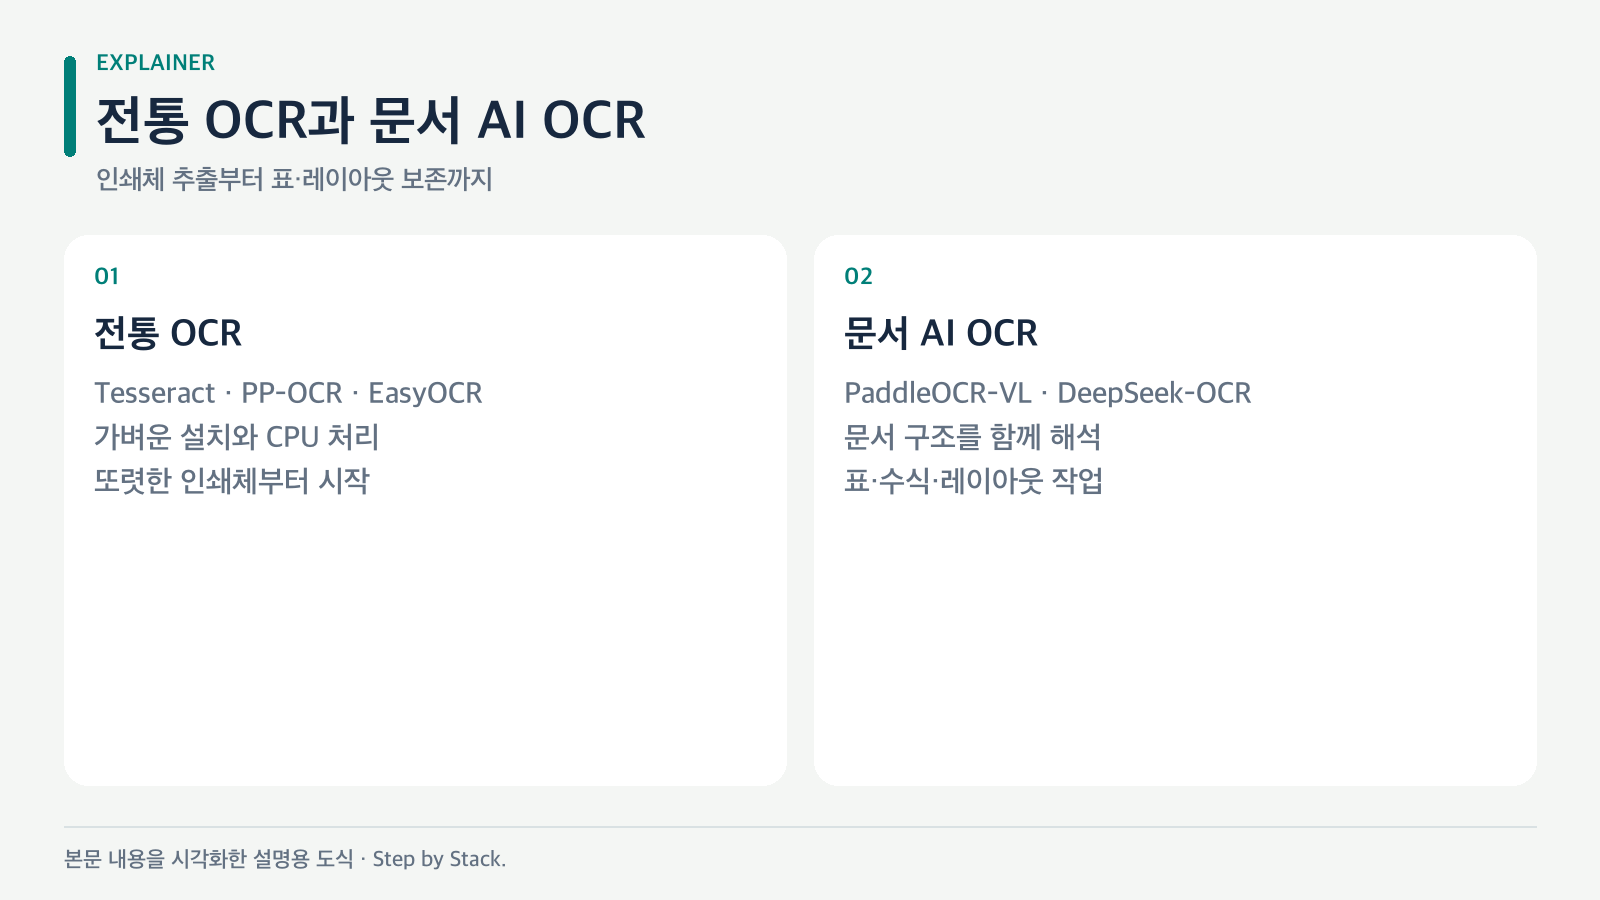
무료로 받아 쓸 수 있는 대표 오픈소스 OCR을 정리하면 다음과 같다. 숫자는 각 공식 저장소와 2026년 벤치마크 정리 글에서 확인한 값이다.
| 도구 | 유형 | 언어(한글) | 크기·요건 | 라이선스 | 강점 |
|---|---|---|---|---|---|
| Tesseract 5 | 전통(LSTM) | 100+ (kor 지원) | CPU로 충분 | Apache 2.0 | 가볍고 설치 쉬움, 또렷한 인쇄체 |
| PP-OCR (PaddleOCR) | 전통·경량 | 50+ (한글) | 수십 MB급 | Apache 2.0 | 속도·실용성 균형 |
| EasyOCR | 전통 | 80+ | 중간 | Apache 2.0 | 간단한 파이썬 API |
| PaddleOCR-VL | 문서 VLM | 109 (한글) | 0.9B · VRAM 약 2GB | Apache 2.0 | OmniDocBench 1위, 표·레이아웃 |
| MinerU2.5-Pro | 문서 VLM | 다국어 | 1.2B | Apache 2.0 | 문서 파싱 2위 |
| dots.ocr | 문서 VLM | 약 100 | 1.7B · VRAM 약 3.5GB | MIT | 양식·구조 문서 |
| DeepSeek-OCR | VLM | 약 100 | 3B급(MoE) · VRAM 약 8GB | MIT | 대량 배치 처리량 |
| GOT-OCR 2.0 | VLM | 20+ | 약 0.58B · VRAM 3GB 미만 | 저장소 확인 | 수식·표·악보 특화 |
전통형(Tesseract·PP-OCR·EasyOCR)은 CPU만으로도 돌아가고 설치가 간단하다. 반면 AI형(PaddleOCR-VL·DeepSeek-OCR 등)은 GPU가 있으면 표·레이아웃·수식 같은 복잡한 구조까지 통째로 살려 준다. PaddleOCR 공식 저장소 기준 PaddleOCR-VL은 109개 언어를 지원하며 여기에 한국어가 포함된다.
내 상황이면 뭘 골라야 하나
용도부터 정하면 선택이 빨라진다. 아래 체크리스트로 좁혀 보자.
- 가끔 캡처 한두 장, 인쇄체 위주 → Tesseract. CPU만으로 충분하고 한글은
kor데이터만 받으면 된다. - 파이썬으로 간단히 자동화 → EasyOCR 또는 PP-OCR. 몇 줄이면 이미지에서 텍스트를 뽑는 스크립트를 짤 수 있다.
- 표·수식·레이아웃이 중요한 문서(PDF, 보고서, 논문) → PaddleOCR-VL. 벤치마크 1위에 VRAM 약 2GB면 돌아가 가성비가 좋다.
- 민감 문서라 외부 업로드가 곤란 → 전부 로컬 오픈소스로. 파일을 바깥 서버에 올리지 않는 게 핵심이다.
- 스캔본 수천 장을 한꺼번에 → DeepSeek-OCR처럼 처리량에 강한 모델을 GPU에서. 다만 VRAM 요구치(약 8GB)가 올라간다.
- 수식·표·악보 같은 특수 구조 → GOT-OCR 2.0이 이 영역에 특화돼 있다.
반대로 "회원가입 없이 지금 당장 한 장만" 같은 상황이면 브라우저·문서 앱에 내장된 무료 OCR을 써도 된다. 다만 이런 서비스는 보통 이미지를 서버로 보내 처리하므로, 계약서·신분증·내부 자료처럼 민감한 문서는 업로드 전에 한 번 더 생각하는 게 좋다.
로컬에서 직접 돌려 보기
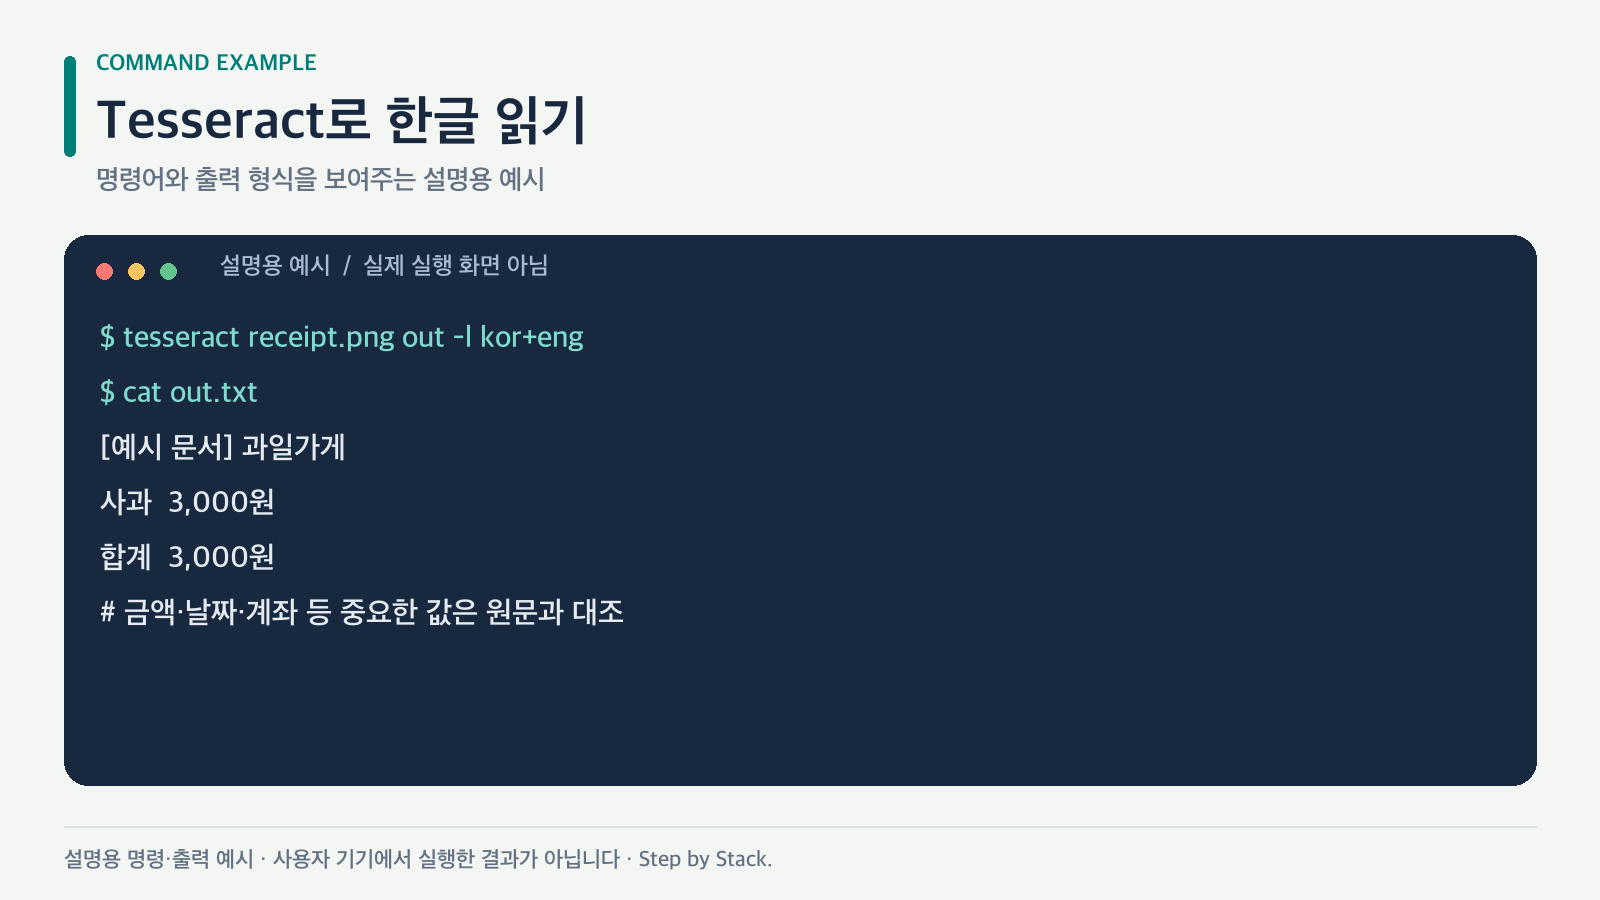
가장 손쉬운 출발점은 Tesseract다. 설치 후 명령 한 줄이면 이미지에서 텍스트가 나온다. 공식 문서 기준 기본 사용법은 다음과 같다.
# 기본 (영어)
tesseract imagename outputbase

# 한국어 지정 (-l kor)
tesseract receipt.png out -l kor

# 한국어 + 영어 혼합 문서
tesseract receipt.png out -l kor+eng
한글을 인식하려면 언어 데이터(kor.traineddata)가 필요하다. 공식 tessdata 저장소에는 한국어 데이터 kor.traineddata와 세로쓰기용 kor_vert.traineddata가 모두 들어 있으니, 배포판 패키지로 설치하거나 저장소에서 받아 tessdata 폴더에 넣으면 된다. 참고로 여러 언어를 섞어 줄 때는 -l kor+eng처럼 +로 이어 쓰며, 언어 순서에 따라 속도와 정확도가 달라질 수 있어 문서 성격에 맞게 바꿔 보는 게 좋다.
문서 구조까지 살리고 싶고 GPU가 있다면 PaddleOCR-VL이 다음 후보다. 0.9B 모델이라 FP16에서 VRAM 약 2GB(INT8은 약 1GB)면 동작해, 외장 그래픽이 있는 홈서버나 미니 PC에서도 무리가 없다. 설치·실행 절차는 PaddleOCR 3.x부터 2.x와 호환되지 않게 바뀌었으니, 아래 공식 문서의 Quick Start를 그대로 따르는 것을 권한다. 가벼운 이미지·단위 변환 같은 작업은 설치 없이 웹에서 끝낼 수도 있다 — 블로그의 무료 도구 모음도 참고하자.
쓰기 전 주의할 점
- 개인정보·보안: 업로드형 무료 웹 OCR은 편하지만 파일이 외부로 나간다. 민감 문서는 로컬 모델로 처리하자.
- 손글씨·흐린 스캔: AI OCR이 좋아졌어도 악필 손글씨나 저해상도 스캔은 여전히 오인식이 잦다. 중요한 숫자(금액·날짜·계좌)는 꼭 눈으로 재확인해야 한다.
- 표·수식: 단순 인쇄체는 전통 엔진으로 충분하지만, 복잡한 표·수식은 문서 특화 VLM이 유리하다. 용도에 맞게 골라야 품이 줄어든다.
- 라이선스: 상업적 서비스에 넣을 거라면 각 모델의 라이선스를 확인하자. 위 표의 다수가 Apache 2.0·MIT로 비교적 자유롭지만, GOT-OCR처럼 별도 확인이 필요한 경우도 있다.
- 저작권: 남의 책·유료 자료를 통째로 OCR해 재배포하는 건 별개 문제다. 내 문서를 디지털화하는 용도로만 쓰는 게 안전하다.
정리
2026년의 무료 OCR은 두 갈래다. 가볍고 설치 쉬운 전통 엔진(Tesseract·PP-OCR·EasyOCR)과, 문서 구조까지 통째로 읽어 내는 작은 AI 모델(PaddleOCR-VL·DeepSeek-OCR·dots.ocr)이다. 한두 장이면 Tesseract로 바로 끝내고, 표·수식이 얽힌 문서나 대량 처리는 GPU에 올린 문서 특화 VLM으로 가면 된다. 공통 원칙 하나만 기억하자 — 민감한 문서일수록 바깥 서버가 아니라 내 기기에서 처리하는 것이 가장 안전하다.
참고 자료
관련글
댓글
댓글을 불러오는 중입니다...